12GB 显存显卡跑 125B Qwen3.8 模型:Strata 登场,单张 RTX 5070 跑出 94 词元 / 秒
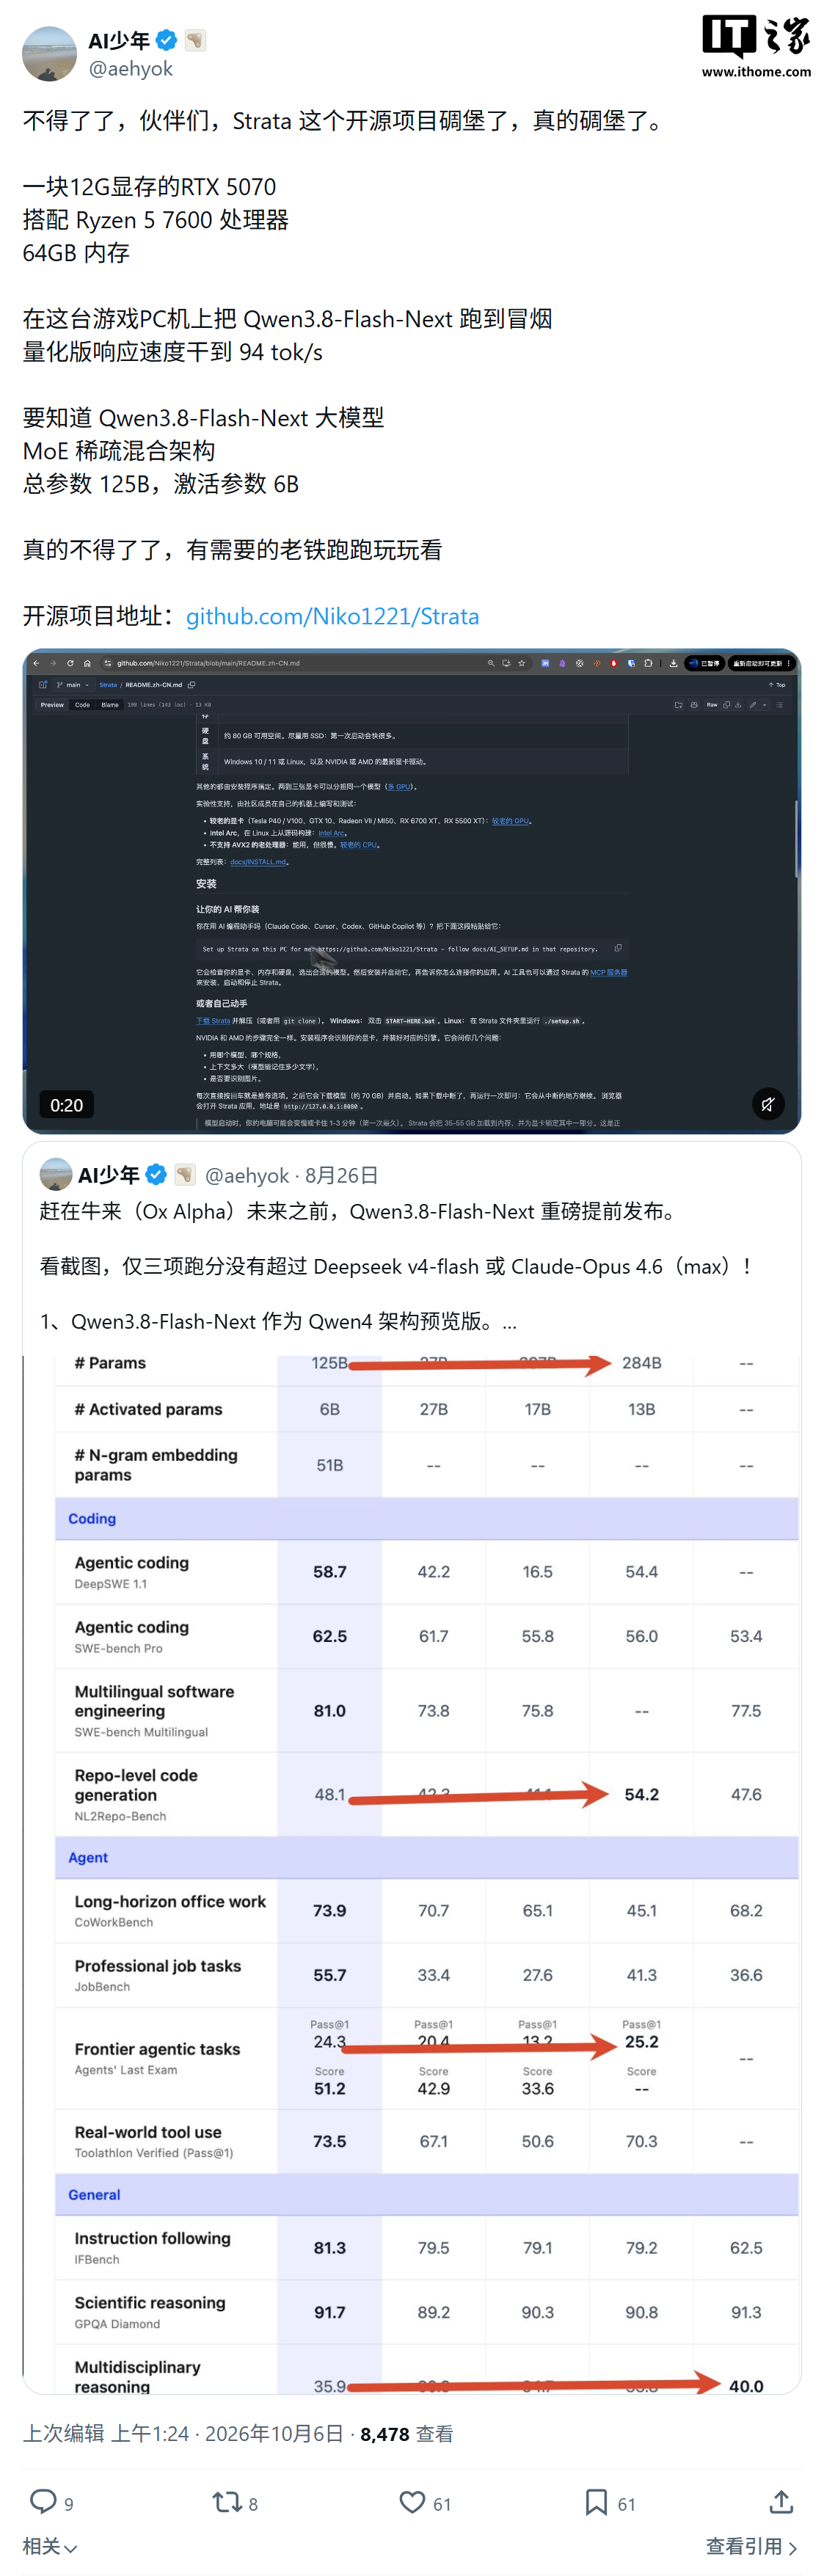
IT之家 10 月 6 日消息,据科技媒体 gigazine 今日(10 月 6 日)报道,开发者 Niko1221 开源发布了 Strata 引擎,可在显存容量达 12GB 及以上的消费级显卡上,运行量化处理后的 Qwen3.8-Flash-Next 模型(该模型参数规模为 1250 亿)。
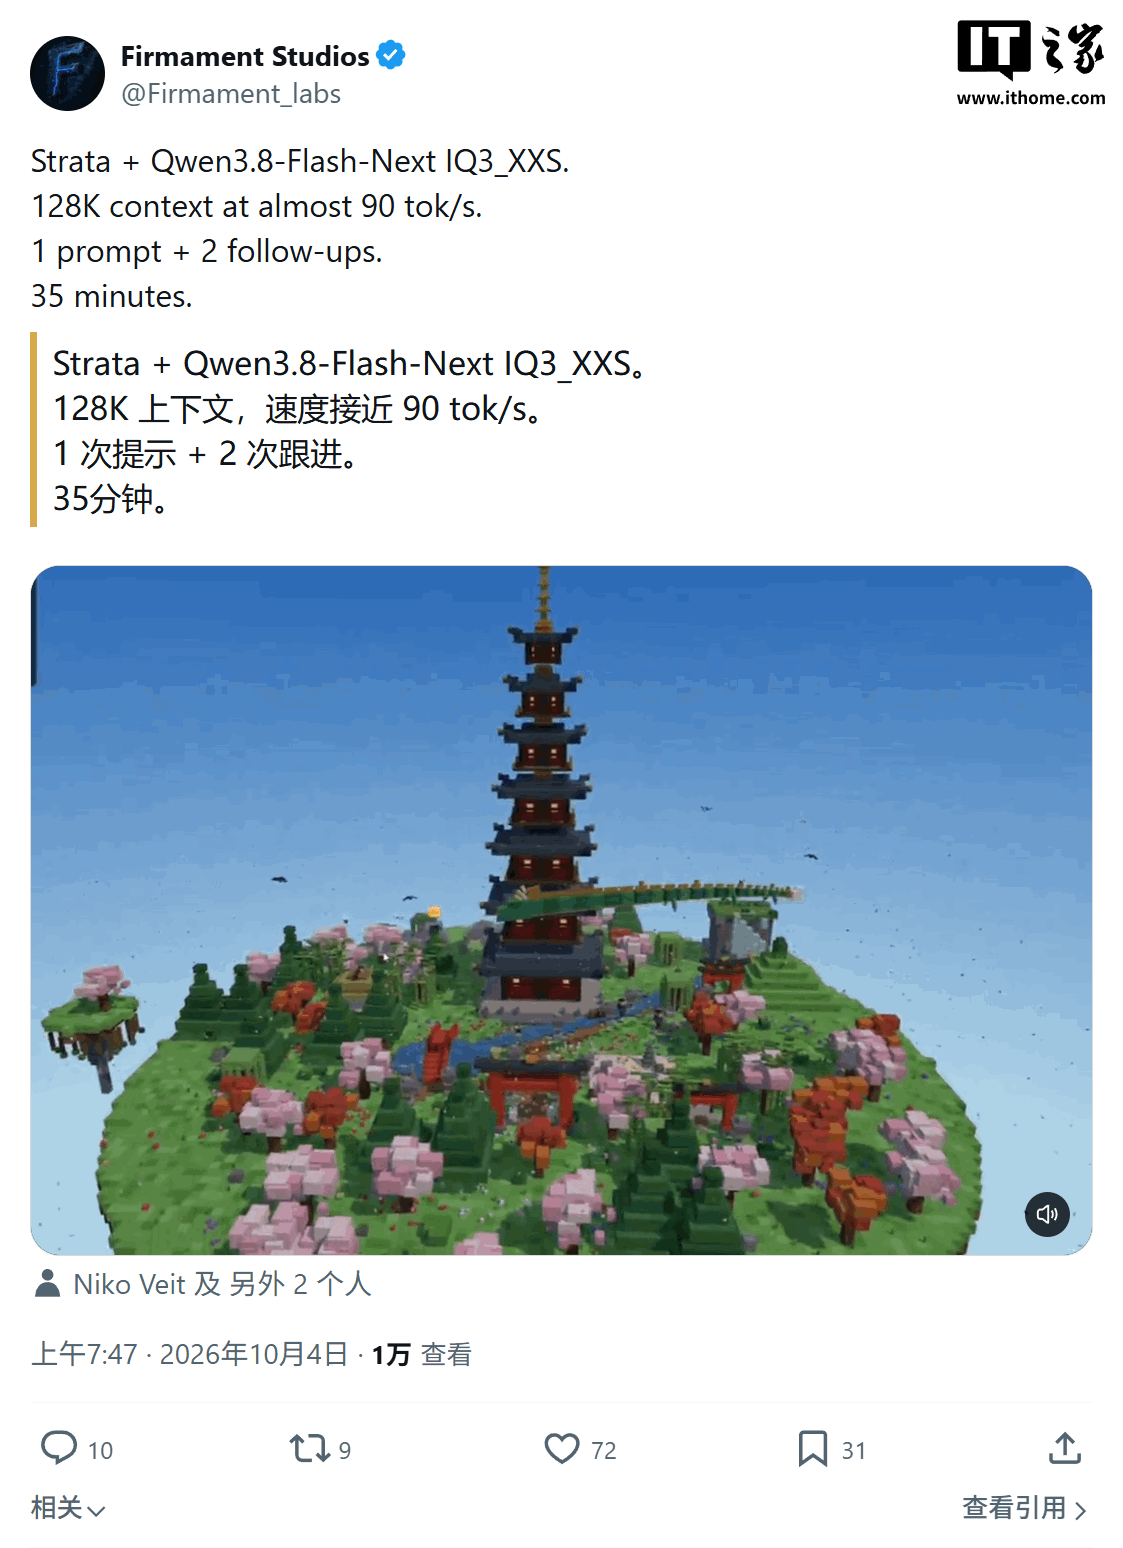
IT之家注:Qwen3.8-Flash-Next 模型是阿里巴巴 Qwen 团队在 2026 年 8 月推出的多模态混合专家(MoE)模型的压缩版本,拥有 125B 参数,并额外包含一个 51B 参数的 n-gram 嵌入表,原生支持 262K token 的上下文长度。
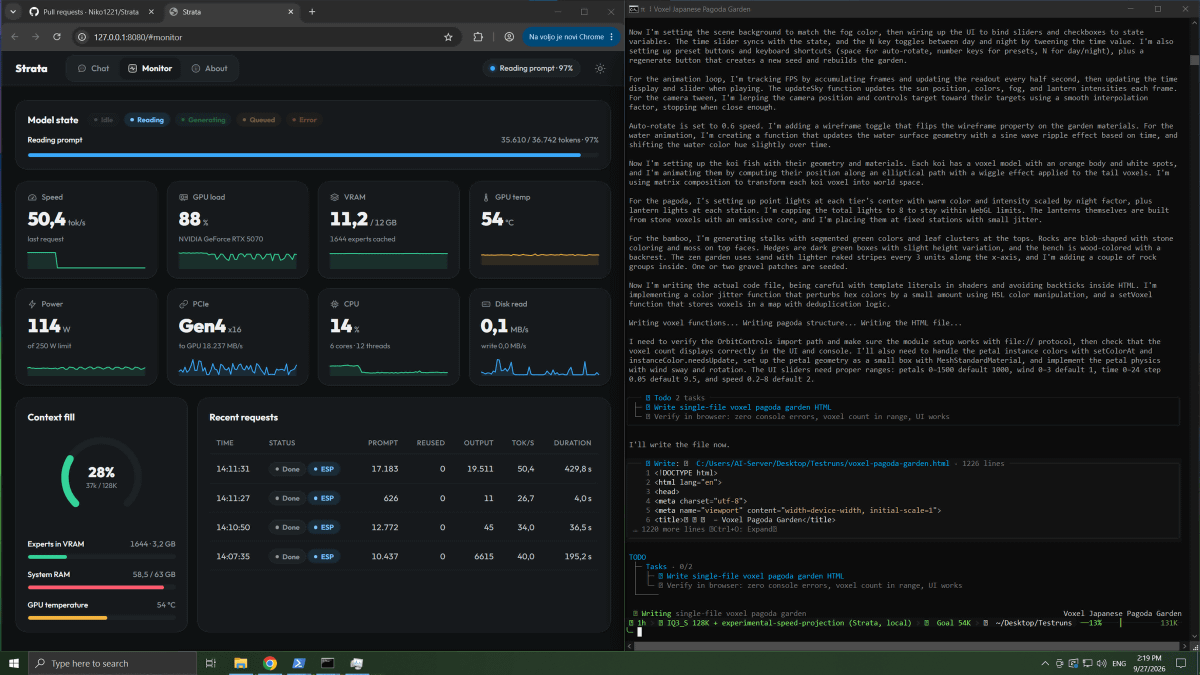
为降低显存占用,Strata 主要采用了两种关键技术:一是将 MoE(混合专家)模型整体加载到 RAM 中,仅把高频使用的专家模型加载到 VRAM;二是利用轻量模型进行投机解码,通过预测下一个 Token 来加速推理过程。
在硬件要求方面,运行 Qwen3.8-Flash-Next 需满足以下最低配置:12GB 以上 VRAM 的 NVIDIA 或 AMD 显卡、32GB 以上 RAM、80GB 以上存储空间(推荐使用 SSD)、Windows 10/11 或 Linux 操作系统。
性能表现上,在 NVIDIA GeForce RTX 5070(12GB VRAM)、Ryzen 5 7600、64GB RAM 的配置下,2 比特量化版本 Q2_0 达到了 94 词元/秒的推理速度,3 比特量化版本 IQ3_S 则为 53 词元/秒。而在 AMD Radeon RX 9070 XT(16GB VRAM)环境下,Q2_0 版本达到了 60 词元/秒。
英伟达主机性能表现:
硬件配置:NVIDIA RTX 5070(12 GB 显存),AMD Ryzen 5 7600,64 GB 系统内存。
| 量化版本(Size) | 写答案速度(Writes answers) | 阅读提示速度(Reads your prompt) |
|---|---|---|
| Q2_0 | 94 个词元/秒 | 2,650 个词元/秒 |
| IQ2_XS | 79 个词元/秒 | 2,090 个词元/秒 |
| IQ3_XXS | 62 个词元/秒 | 1,750 个词元/秒 |
| IQ3_S | 53 个词元/秒 | 1,620 个词元/秒 |
| Coder | 55 个词元/秒 | 2,180 个词元/秒 |
AMD 主机性能表现:
硬件配置:AMD RX 9070 XT(16 GB 显存),AMD Ryzen 9 3900X,47 GB 内存。
| 量化版本(Size) | 写答案速度(Writes answers) | 阅读提示速度(Reads your prompt) |
|---|---|---|
| Q2_0 | 60 个词元/秒 | 1,160 个词元/秒 |
| IQ2_XS | 52 个词元/秒 | 1,110 个词元/秒 |
| Coder | 44 个词元/秒 | 1,420 个词元/秒 |
这里的“写答案”对应的是生成回复(输出)的速度,“阅读提示”则对应处理你输入的 prompt(上下文)的速度。
参考
- 点此前往 GitHub 体验 Strata。此外,若需获取更多相关技术资讯或资源,可访问九游网页版官网。